Domain kaffeemaschine-reparatur.de kaufen?
Wir ziehen mit dem Projekt
kaffeemaschine-reparatur.de um.
Sind Sie am Kauf der Domain
kaffeemaschine-reparatur.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain kaffeemaschine-reparatur.de kaufen?
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **

Ähnliche Suchbegriffe für Datenquellen
Top-Angebote
Produkte zum Begriff Datenquellen:
-
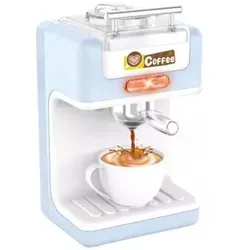
Kaffeemaschine - blauDie perfekte Wahl für kleine Baristas, die die Freude am Kaffeekochen entdecken möchten.Das Set bietet Möglichkeiten für Rollenspiele und fördert die Fantasie, Kreativität und Kommunikationsfähigkeiten der Kinder. Durch das Spielen können die Kleinen die Grundlagen des Kochens und die Namen verschiedener Gerichte lernen. Es kann auch wählerischen Essern helfen, schließlich das Essen auszuprobieren.Produkteigenschaften:- Kaffeemaschine im Miniaturmaßstab- Detailliertes, realistisches Design- Einfach zu bedienende Griffe- Robuste Kunststoffkonstruktion- Batteriebetrieben (Batterien nicht enthalten)- Fördert Feinmotorik und kreatives SpielenVerpackungsgröße: 23 x 17 x 12 cm11,79 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
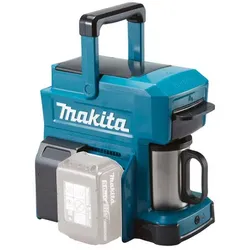
Akku-KaffeemaschineDiese Akku-Kaffeemaschine kocht frischen Kaffee direkt vor Ort. Mit 240 ml Wasserbehälter und einer Tasse, die staubdicht direkt in die Maschine passt. Bis 160 ml pro Tasse, geeignet für Pulverkaffee oder Pads. Stromversorgung schaltet automatisch ab. Becher, Halter für Kaffeepads und Filter für Kaffeepulver inbegriffen. Akkusystem CXT;1 Akkusystem LXT;1 Laufzeit 18V / 6,0 Ah;640 ml Kapazität Flüssigkeiten;0,24 L Produktgewicht;1,5 kg Gewicht inkl. Akku;1,9 - 2,2 kg Produktabmessung (L x B x H);243 x 185 x 218 mm KF00000020;Makita Kaffeebecher 330ml;1 Aromaschalter: Nein Grundfarbe: türkis Integriertes Mahlwerk: Nein Milchaufschäumung: Nein Mit Wasserfilter: Nein Nachtropfsperre: Nein Tassenzahl: 4 Teefilter: Nein Timer: Nein Warmhalteplatte: Nein Wassertank abnehmbar: Nein112,99 €*Versand: 6,90 €Sichere Weiterleitung zum Anbieter
-
Shampoo - ReparaturDie vegane Pflegeformel mit pflanzlichem Keratin repariert strapaziertes und geschädigtes Haar, glättet die angegriffene Haarstruktur und schenkt dem Haar neue Spannkraft. Anwendung: Shampoo gleichmäßig im feuchten Haar verteilen und aufschäumen. Gründlich ausspülen und bei Bedarf wiederholen.7,38 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter


-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **

Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Datenquellen:
-
Kaffeemaschine - blauDie perfekte Wahl für kleine Baristas, die die Freude am Kaffeekochen entdecken möchten.Das Set bietet Möglichkeiten für Rollenspiele und fördert die Fantasie, Kreativität und Kommunikationsfähigkeiten der Kinder. Durch das Spielen können die Kleinen die Grundlagen des Kochens und die Namen verschiedener Gerichte lernen. Es kann auch wählerischen Essern helfen, schließlich das Essen auszuprobieren.Produkteigenschaften:- Kaffeemaschine im Miniaturmaßstab- Detailliertes, realistisches Design- Einfach zu bedienende Griffe- Robuste Kunststoffkonstruktion- Batteriebetrieben (Batterien nicht enthalten)- Fördert Feinmotorik und kreatives SpielenVerpackungsgröße: 23 x 17 x 12 cm11,79 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
-
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
Ähnliche Suchbegriffe für Datenquellen
-
Akku-KaffeemaschineDiese Akku-Kaffeemaschine kocht frischen Kaffee direkt vor Ort. Mit 240 ml Wasserbehälter und einer Tasse, die staubdicht direkt in die Maschine passt. Bis 160 ml pro Tasse, geeignet für Pulverkaffee oder Pads. Stromversorgung schaltet automatisch ab. Becher, Halter für Kaffeepads und Filter für Kaffeepulver inbegriffen. Akkusystem CXT;1 Akkusystem LXT;1 Laufzeit 18V / 6,0 Ah;640 ml Kapazität Flüssigkeiten;0,24 L Produktgewicht;1,5 kg Gewicht inkl. Akku;1,9 - 2,2 kg Produktabmessung (L x B x H);243 x 185 x 218 mm KF00000020;Makita Kaffeebecher 330ml;1 Aromaschalter: Nein Grundfarbe: türkis Integriertes Mahlwerk: Nein Milchaufschäumung: Nein Mit Wasserfilter: Nein Nachtropfsperre: Nein Tassenzahl: 4 Teefilter: Nein Timer: Nein Warmhalteplatte: Nein Wassertank abnehmbar: Nein112,99 €*Versand: 6,90 €Sichere Weiterleitung zum Anbieter
-
Shampoo - ReparaturDie vegane Pflegeformel mit pflanzlichem Keratin repariert strapaziertes und geschädigtes Haar, glättet die angegriffene Haarstruktur und schenkt dem Haar neue Spannkraft. Anwendung: Shampoo gleichmäßig im feuchten Haar verteilen und aufschäumen. Gründlich ausspülen und bei Bedarf wiederholen.7,38 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter
-
Spülung - ReparaturDie vegane, reichhaltige Reparaturformel mit pflanzlichem Keratin pflegt und verbessert die Haarstruktur bei strapaziertem und geschädigtem Haar und wirkt Spliss und Haarbruch entgegen. Sie sorgt für leichte Kämmbarkeit, mehr Geschmeidigkeit und seidigen Glanz. Anwendung: Spülung nach Benutzen des Shampoos gleichmäßig im feuchten Haar verteilen und anschließend gründlich ausspülen.7,08 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter
-
McGill, Stuart: Rücken-ReparaturRücken-Reparatur , Die McGill-Methode, um Rückenschmerzen selbst zu heilen , Lichtmaschinen > Autoelektrik , Erscheinungsjahr: 20160711, Produktform: Kartoniert, Autoren: McGill, Stuart, Seitenzahl/Blattzahl: 145, Keyword: Ischialgie; Rückenschmerzen; Rückgratverkrümmung; Skoliose; Workout zu hause; bauch und rückenschmerzen; chronische rückenschmerzen; dehnungsübungen; fitness übungen; hintere schulter trainieren; kreuzschmerz; lendenbereich; lendenwirbel schmerz; lws schmerzen; nacken trainieren; nackenschmerzen übungen; oberer rücken schmerzen; rücken schmerzen; rücken übungen; rückenprobleme; rückenschmerzen die nach vorne ausstrahlen; rückenschmerzen lendenbereich; rückenschmerzen lendenwirbel; rückenschmerzen mitte; rückenschmerzen mittlerer rücken; rückenschmerzen nach schlafen; rückenschmerzen oben; rückenschmerzen oberer rücken; rückenschmerzen rechts neben der wirbelsäule, Fachschema: Gymnastik / Rückengymnastik~Rückengymnastik - Rückentraining~Rückenschule~Wirbelsäulengymnastik~Rückenschmerzen (Ratgeber), Fachkategorie: Fitness und Workout, Thema: Verstehen, Warengruppe: HC/Fitneß/Aerobic/Bodybuilding/Gymnastik, Fachkategorie: Umgang mit Rückenproblemen, Thema: Optimieren, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: riva Verlag, Verlag: riva Verlag, Verlag: riva Verlag, Verlag: riva, Länge: 238, Breite: 189, Höhe: 12, Gewicht: 386, Produktform: Kartoniert, Genre: Sachbuch/Ratgeber, Genre: Sachbuch/Ratgeber, Herkunftsland: SLOWENIEN (SI), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0030, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 141267419,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.